معرفی پروژه
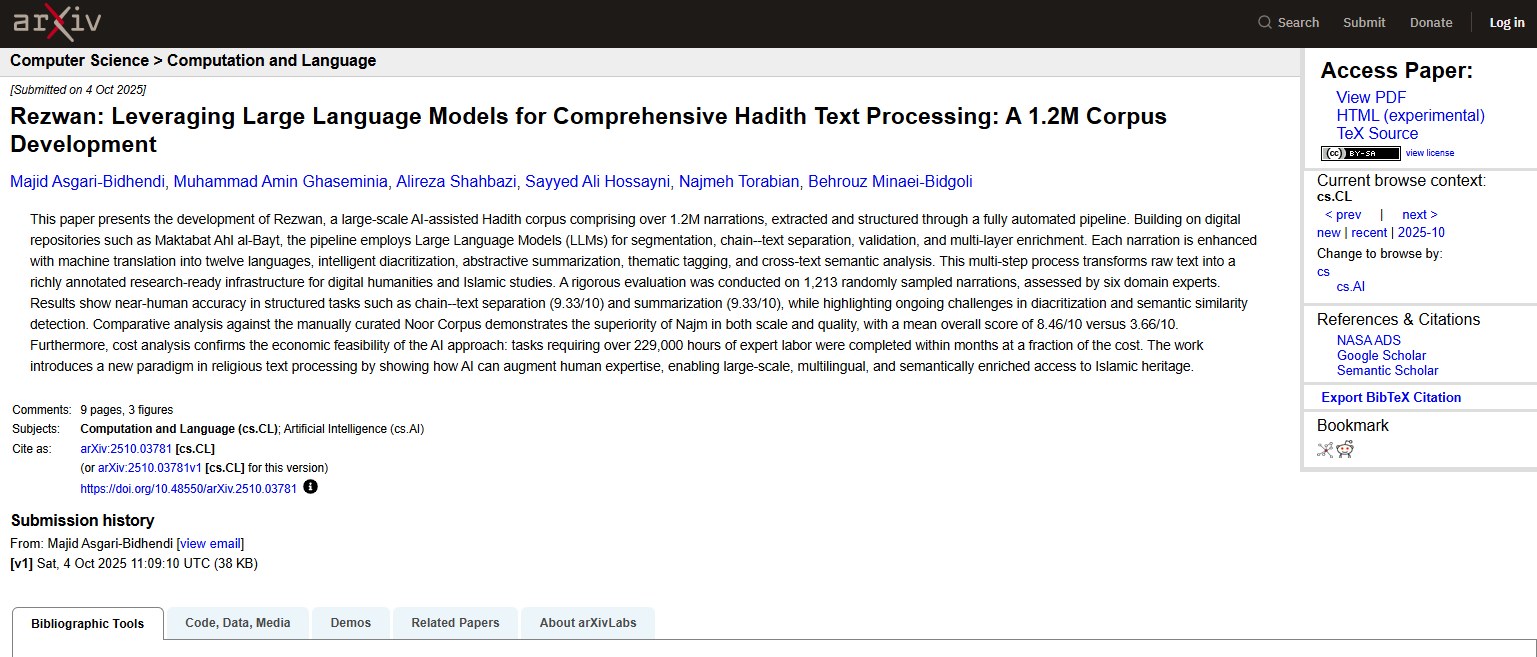
رضوان یک زیرساخت پژوهشی برای پردازش گسترده متون حدیثی است که بیش از ۱٫۲ میلیون روایت را در قالب یک پیکره ساختیافته گردآوری کرده است. مسیر مبتنی بر مدلهای زبانی بزرگ، منابع خام را بخشبندی و سند را از متن روایت جدا میکند و سپس لایههای پژوهشی تازهای به داده میافزاید.
قابلیتهای پژوهشی
ترجمه ماشینی به دوازده زبان، اعرابگذاری هوشمند، خلاصهسازی، برچسبگذاری موضوعی و تحلیل میانمتنی از اجزای سامانهاند. استفاده از مخازنی مانند مکتبة اهلالبیت، این پروژه را برای پژوهشگران حدیث و میراث شیعی نیز قابلتوجه میکند. پیکره میتواند برای بازیابی معنایی، مقایسه روایتها و طراحی پژوهشهای کمی در مطالعات اسلامی به کار رود.
ارزیابی و احتیاط روشی
پژوهشگران ۱۲۱۳ نمونه را با مشارکت شش متخصص حوزه ارزیابی کردهاند. نتایج گزارششده برای جداسازی سند و متن و خلاصهسازی قویتر است، اما در اعرابگذاری و سنجش شباهت معنایی هنوز محدودیت وجود دارد. بنابراین خروجی سامانه باید ابزار کمکی پژوهشگر تلقی شود و جایگزین نقد سند، نسخه و متن نیست. متن و جزئیات در صفحه مقاله در دسترس است.